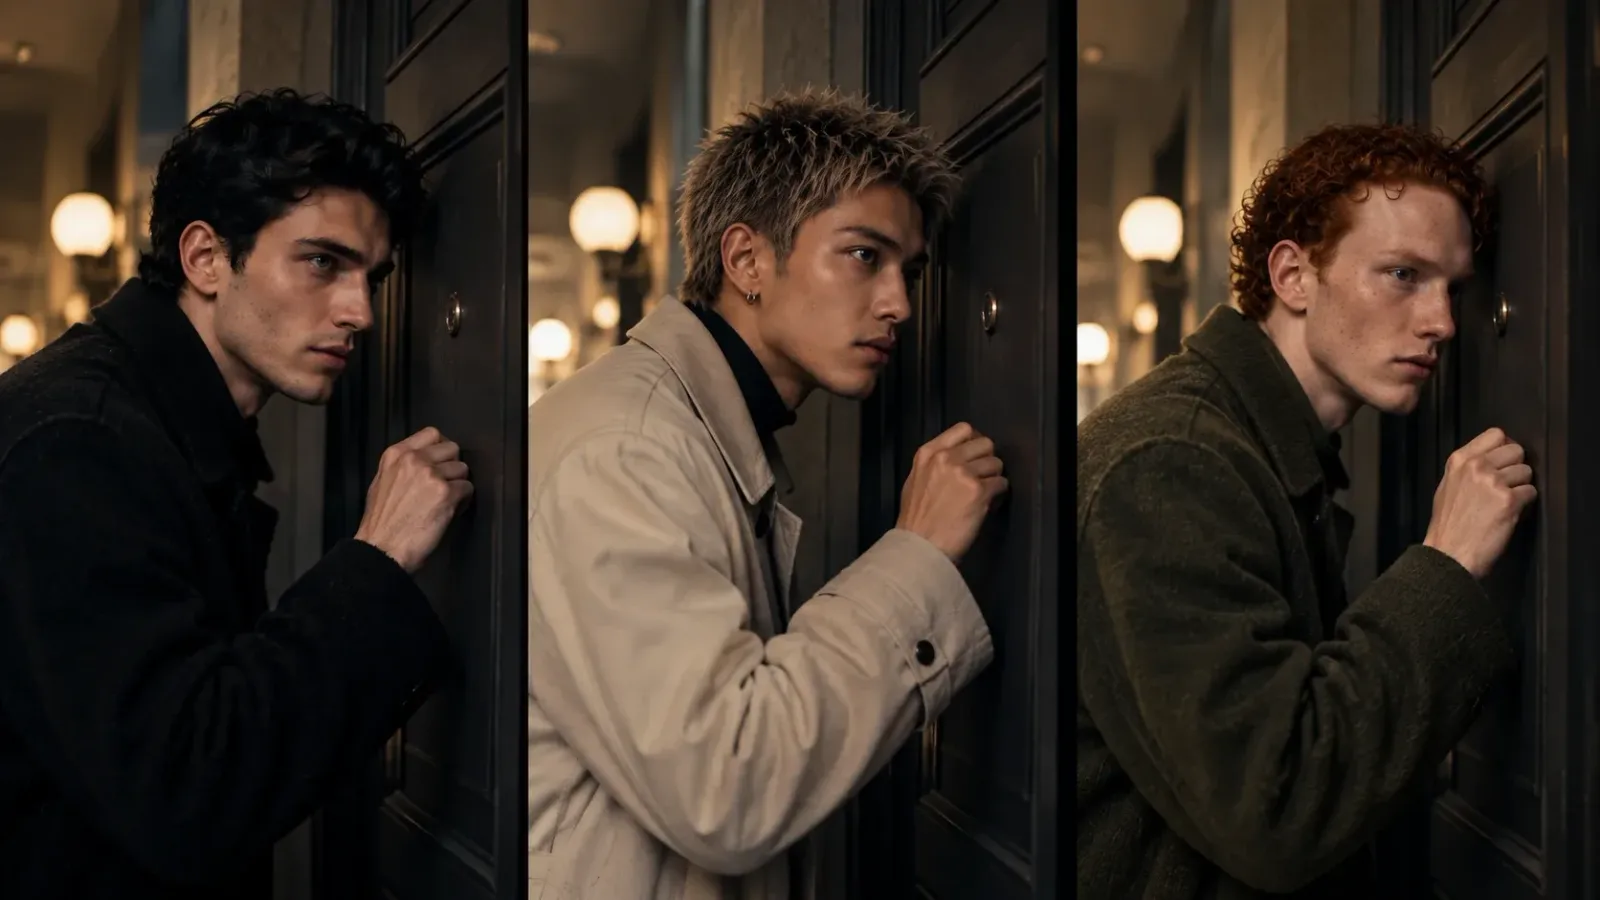
设想一位虚构角色走到一扇关着的门前,听见门后有声音,并决定是否敲门。三个吸引人的画格也许能描述整个场景,却无法告诉我们角色听了多久,手是否马上抬起,或敲门前观众理解了什么。这些间隔也是表演的一部分。即使面孔和环境完全相同,选择间隔仍会改变角色。
对正在探索动态影像中人工智能身份的创意团队而言,在追求精致序列之前先解决这个问题很有用。肖像建立一种存在感;场景则给这种存在感做事的时间。这种转变不只是给静帧加上动作。它需要让发生的事情、角色注意到的事情,以及观众何时也能察觉之间形成关系。
先看粗略版本,再要求完成版
动态故事板是一种初步序列,把分镜画面按时间排列,让团队在制作最终动画之前看到场景如何展开。 ScreenSkills 制定的前期视觉化职业标准把时间安排、转场、临时对白、声音和节奏列为计划应传达的内容。这是成熟的动画实践,不是为生成式 AI 新发明的技术。
门口场景的粗略序列可以包括走近的画面、角色倾听的画面,以及举起手的画面。临时声音标记打断走近过程的事件。其目的是测试敲门这个决定是否清楚易懂。如果声音与反应的关系仍不清楚,再精美的走廊渲染也无助于这项测试。
这与定义视觉身份是不同阶段,后者见于 我们对电影中人工角色的探讨。这里的身份和前提可能已经确定,仍待决定的是场景中的表演。粗略序列让协作者可以一起观看,而不必各自从一段文字中想象时间安排。
区分停顿与空白间隔
试试这个假设场景的两个版本。第一个版本里,角色听见声音后立刻敲门。第二个版本里,角色先听一会儿,稍稍放低手,然后敲门。事件相似,呈现的态度却不同。一种解读可能是自信;另一种可能是先犹豫、再下定决心。这些解读都不会自动成为关于角色的事实,而是团队可以对照预期故事来比较的解释。
停顿需要某种东西来支撑。门后持续的声音、手部动作的变化或注意力的转移,都能赋予间隔以目的。只是让一幅好看的画面停留更久,可能让观众一直等待却什么也没学到。审看粗剪时,描述等待期间发生了什么变化。如果没人能指出变化,就重新考虑时长或动作。
没有一个放之四海皆准的秒数能让犹豫显得可信。周边序列很重要。快速抵达之后静止,与本来就缓慢的接近形成的对比不同。应在上下文中比较这段内容,包括它前后紧接着发生什么,而不是把停顿当作孤立效果来批准。
用声音揭示画面无法展示的内容
画面之外的声音能在不增加镜头的情况下,为门口场景提供信息。它可能是椅子移动、谈话停止,或小物件掉落的声音。不同选择暗示角色倾听的不同原因。临时音轨在这里很有用,因为团队可以在确定最终声音处理之前测试两者的关系。
用同一组画面分别试试声音提早出现和延后出现的版本。一种安排中,观众可能先听见声音,之后才看到角色似乎有所反应;另一种安排中,声音与反应可能显得同步。观察这些安排会引导观众推断什么。这是针对这个虚构场景的编辑提议,并非声称某种安排会让所有观众产生相同情绪。
临时对白也需要类似的谨慎。回答前的空隙可能承载思考、不确定,或意图变化。单靠文字无法决定是哪一种。配合画面大声读出对话,留出足够空间听清回应在做什么。音乐可以之后再考虑,免得其情绪方向成为原本不清楚的对话看似有效的唯一原因。
让时间安排保持可调整,以便从结果中学习
序列变得有用后,它的时间安排可以为下一份制作创意简报提供参考。描述必须发生的动作、观众需要的信息,以及转场应放在哪里。预设时长是规划参考,不代表生成片段会遵守所有细节。交付的动态内容仍须放在剪辑中检查。
假设一个新片段里倾听的动作很可信,却过早进入敲门。团队可以检查换一种剪辑能否保留预期的犹豫,或者表演是否需要再试一次。粗略序列让问题具体化,也为能改善场景的结果留出空间:一个小小的非预期动作也许比原始分镜更清楚地表达了这个决定。
这段讨论涉及一种开发动态影像作品的方式,并非声称 Lyfera 目前提供端到端的动画编辑器。人工智能角色可以成为视觉起点,同时分镜、声音和剪辑仍各有制作要求。实际检验标准是:序列能否让观众看懂动作及其后果。可识别的面孔帮助我们知道门边是谁;敲门前的时间帮助我们理解他们在那里做什么。