문화와 관점 · Lyfera · 2026-09-29
AI 캐릭터가 반응할 시간을 주자
알아볼 수 있는 캐릭터라도 읽히는 연기가 필요합니다. 시간에 맞춘 거친 시퀀스는 최종 애니메이션 전에 멈춤, 반응, 전환을 논의할 수 있게 합니다.
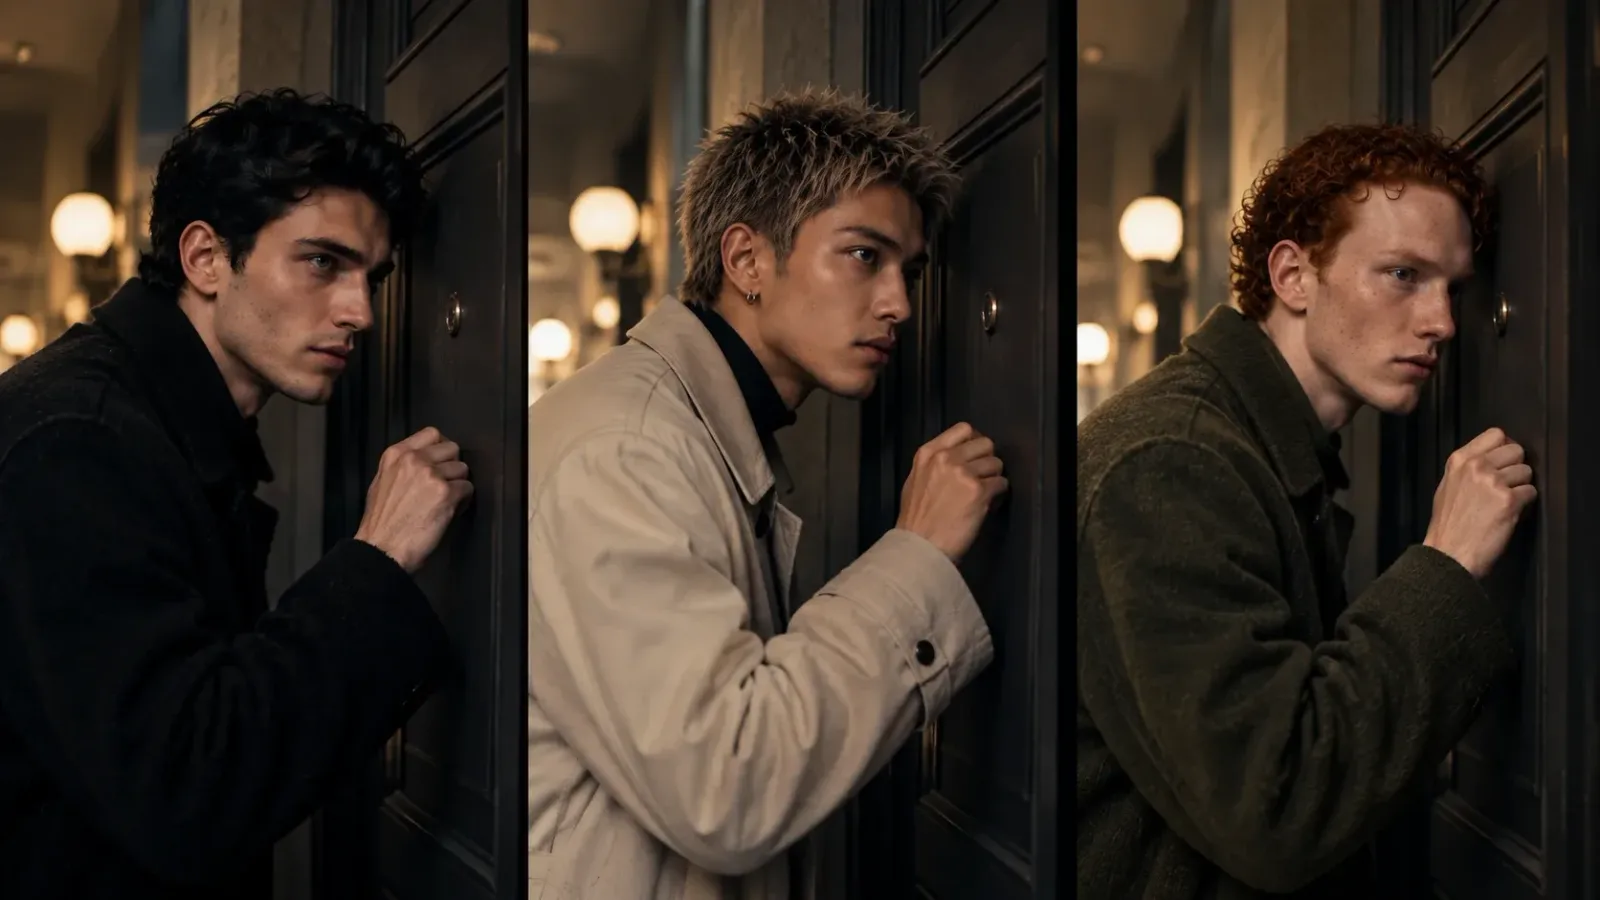
문이 닫힌 곳에 도착한 가상의 탤런트가 반대편에서 소리를 듣고 노크할지 결정하는 장면을 떠올려 보세요. 매력적인 프레임 세 장이면 장면 전체를 묘사할 수 있습니다. 하지만 캐릭터가 얼마나 오래 귀를 기울이는지, 손을 바로 드는지, 노크 전에 관객이 무엇을 이해하는지는 알 수 없습니다. 그런 간격도 연기의 일부입니다. 얼굴과 배경이 같아도 그 시간을 정하면 캐릭터가 달라집니다.
움직이는 이미지에서 인공 정체성을 탐색하는 크리에이티브팀이라면, 세련된 시퀀스를 만들기 전에 이 문제를 결정하는 것이 유용합니다. 포트레이트는 존재감을 세우지만 장면은 그 존재가 무언가를 할 시간을 줍니다. 정지 이미지에 움직임만 더해서는 전환을 만들 수 없습니다. 무슨 일이 벌어지는지, 캐릭터가 무엇을 알아차리는지, 관객에게 그것을 언제 보여줄지의 관계가 필요합니다.
완성본을 요구하기 전에 거친 버전을 살펴보자
애니매틱은 스토리보드 이미지를 시간 순서로 배치한 예비 시퀀스입니다. 최종 애니메이션을 만들기 전에 제안된 장면이 어떻게 전개되는지 팀이 확인할 수 있습니다. 「ScreenSkills가 개발한 사전 시각화 직무 표준」에는 타이밍, 전환, 임시 대사, 사운드, 리듬이 계획에서 전달해야 할 내용으로 포함됩니다. 이는 생성형 AI를 위해 새로 발명된 기법이 아니라 확립된 애니메이션 실무입니다.
문 장면에서는 다가가는 장면, 귀를 기울이는 장면, 손을 든 장면을 그린 그림으로 거친 시퀀스를 만들 수 있습니다. 임시 사운드는 접근을 방해하는 사건을 표시합니다. 노크하겠다는 결정이 읽히는지 시험하는 것이 목적입니다. 소리와 반응의 관계가 여전히 모호하다면, 정교하게 렌더링한 복도는 그 시험에 거의 도움이 되지 않습니다.
이는 「영화를 위한 인공 캐릭터 탐구」에서 논의한 시각적 정체성의 정의 단계와 다릅니다. 여기서는 정체성과 전제가 이미 정해져 있을 수 있습니다. 장면 안에서 연기를 어떻게 할지는 여전히 열려 있습니다. 거친 시퀀스가 있으면 각자가 글 한 단락만 보고 타이밍을 상상하는 대신 협업자들이 함께 볼 수 있습니다.
멈춤과 텅 빈 간격을 구분하자
가상의 장면을 두 가지로 시험해 보세요. 첫 버전에서는 소리를 듣자마자 노크합니다. 두 번째에서는 귀를 기울이고 손을 조금 내렸다가 노크합니다. 사건은 비슷하지만 제안하는 태도는 다릅니다. 한쪽은 자신감, 다른 쪽은 망설이다 결심하는 모습으로 읽힐 수 있습니다. 어느 쪽도 캐릭터의 변치 않는 사실은 아닙니다. 의도한 이야기와 대조해 볼 수 있는 해석입니다.
멈춤에는 그것을 이어주는 무언가가 필요합니다. 문 뒤에서 계속되는 소리, 손의 움직임, 시선의 변화가 간격에 목적을 줍니다. 매력적인 프레임을 그저 더 오래 보여주면 관객은 아무것도 새로 알지 못한 채 기다릴 수 있습니다. 거친 편집본을 볼 때 기다리는 동안 무엇이 달라지는지 설명해 보세요. 아무도 알아내지 못한다면 길이나 동작을 다시 검토하세요.
망설임을 설득력 있게 만드는 보편적인 초 단위는 없습니다. 주변 시퀀스가 중요합니다. 빠르게 다가온 뒤 멈추는 장면과 이미 천천히 접근하는 장면은 서로 다른 대비를 만듭니다. 멈춤만 따로 승인하지 말고 직전과 직후를 포함해 맥락 속에서 살펴보세요.
그림으로 보이지 않는 것을 소리로 드러낸다
화면 밖에서 나는 소리는 다른 장면을 추가하지 않고도 문 장면에 정보를 줍니다. 의자가 움직이는 소리, 대화가 멈추는 소리, 작은 물체가 떨어지는 소리일 수 있습니다. 무엇을 택하느냐에 따라 캐릭터가 귀를 기울이는 이유가 달라집니다. 임시 트랙은 최종 사운드를 확정하기 전에 그 관계를 시험하게 해줍니다.
같은 그림에서 소리가 더 일찍, 또는 더 늦게 들리도록 해보세요. 한 버전에서는 캐릭터가 반응하기 전에 관객이 소리를 들을 수 있고, 다른 버전에서는 소리와 반응이 즉각적인 것처럼 느껴질 수 있습니다. 이런 배열이 관객에게 무엇을 추론하게 하는지 살펴보세요. 이는 가상의 장면을 위한 편집 제안이지, 특정 배열이 모든 관객에게 같은 감정을 만든다는 주장이 아닙니다.
임시 대사도 비슷한 주의가 필요합니다. 대답 전의 공백은 생각, 불확실함, 의도 변화를 담을 수 있습니다. 말만으로는 어느 쪽인지 정해지지 않습니다. 이미지에 맞춰 대화를 소리 내어 읽고 응답이 무엇을 하는지 들을 만큼 여유를 두세요. 음악은 나중에 살펴볼 수 있습니다. 음악의 감정적 방향이 불분명한 대화를 작동하는 것처럼 보이게 하는 유일한 이유가 되지 않도록 말입니다.
결과를 통해 배울 수 있도록 타이밍을 잠정적으로 유지하자
시퀀스가 유용해지면 그 타이밍을 다음 제작 브리프에 반영할 수 있습니다. 꼭 일어나야 하는 동작, 관객에게 필요한 정보, 전환이 들어갈 지점을 설명하세요. 목표 시간은 계획을 위한 참고이지 생성 클립이 모든 세부사항을 따를 증거는 아닙니다. 전달된 움직임은 편집 안에서 여전히 살펴봐야 합니다.
새 클립에서 귀 기울이는 동작은 설득력 있지만 노크가 너무 일찍 나온다고 해 봅시다. 의도한 망설임을 다른 컷 편집으로 보존할 수 있는지, 연기를 다시 시도해야 하는지 검토할 수 있습니다. 거친 시퀀스가 문제를 구체적으로 드러냅니다. 또한 장면을 개선하는 결과가 나올 여지도 남깁니다. 계획하지 않은 작은 움직임이 원래 그림보다 결심을 더 명확히 보여줄 수 있습니다.
이 논의는 움직이는 이미지 작업을 개발하는 방법에 관한 것이지, Lyfera가 현재 처음부터 끝까지 애니메이션 편집기를 제공한다는 주장이 아닙니다. 인공 탤런트는 시각적 출발점이 될 수 있지만 스토리보드, 사운드, 편집에는 각각의 제작 요건이 남습니다. 시퀀스가 동작과 그 결과를 관객에게 읽히게 하는지가 실질적인 기준입니다. 알아볼 수 있는 얼굴은 문 앞에 누가 있는지 알려줍니다. 노크하기 전의 시간은 그 사람이 거기서 무엇을 하는지 이해하게 합니다.